OpenAI修复GPT-6 Sol与Luna图像编码缺陷:视觉定位成绩从28.8%升至60%
OpenAI确认并修复GPT-6图像理解缺陷
OpenAI Developers于2026年9月27日确认,GPT-6 Sol和GPT-6 Luna此前存在一个图像编码缺陷,会降低模型对图片内容的理解能力。问题现已修复,API和Codex中的视觉任务表现应当改善,其中包括依赖截图识别的计算机操作。
官方API更新日志对问题给出了更准确的定性:这是image encoding,即图像编码环节的Bug。OpenAI没有宣布重新训练模型,也没有发布新的模型版本名称。更合理的理解是,图像输入在进入模型前的处理链路出现了异常,使模型没有获得应有的视觉信息;修复输入处理后,原模型能力恢复。
这次更新对纯文本任务没有直接影响,受影响重点是所有依赖图片输入的工作流。
官方图表显示:Luna视觉定位成绩翻倍
OpenAI随推文发布了一张RefCOCOg视觉定位测试图。GPT-6 Luna在Max推理强度下,修复前后的平均交并比数据如下:
- 修复前:28.8%
- 修复后:60.0%
- 绝对提升:31.2个百分点
- 相对提升:约108%
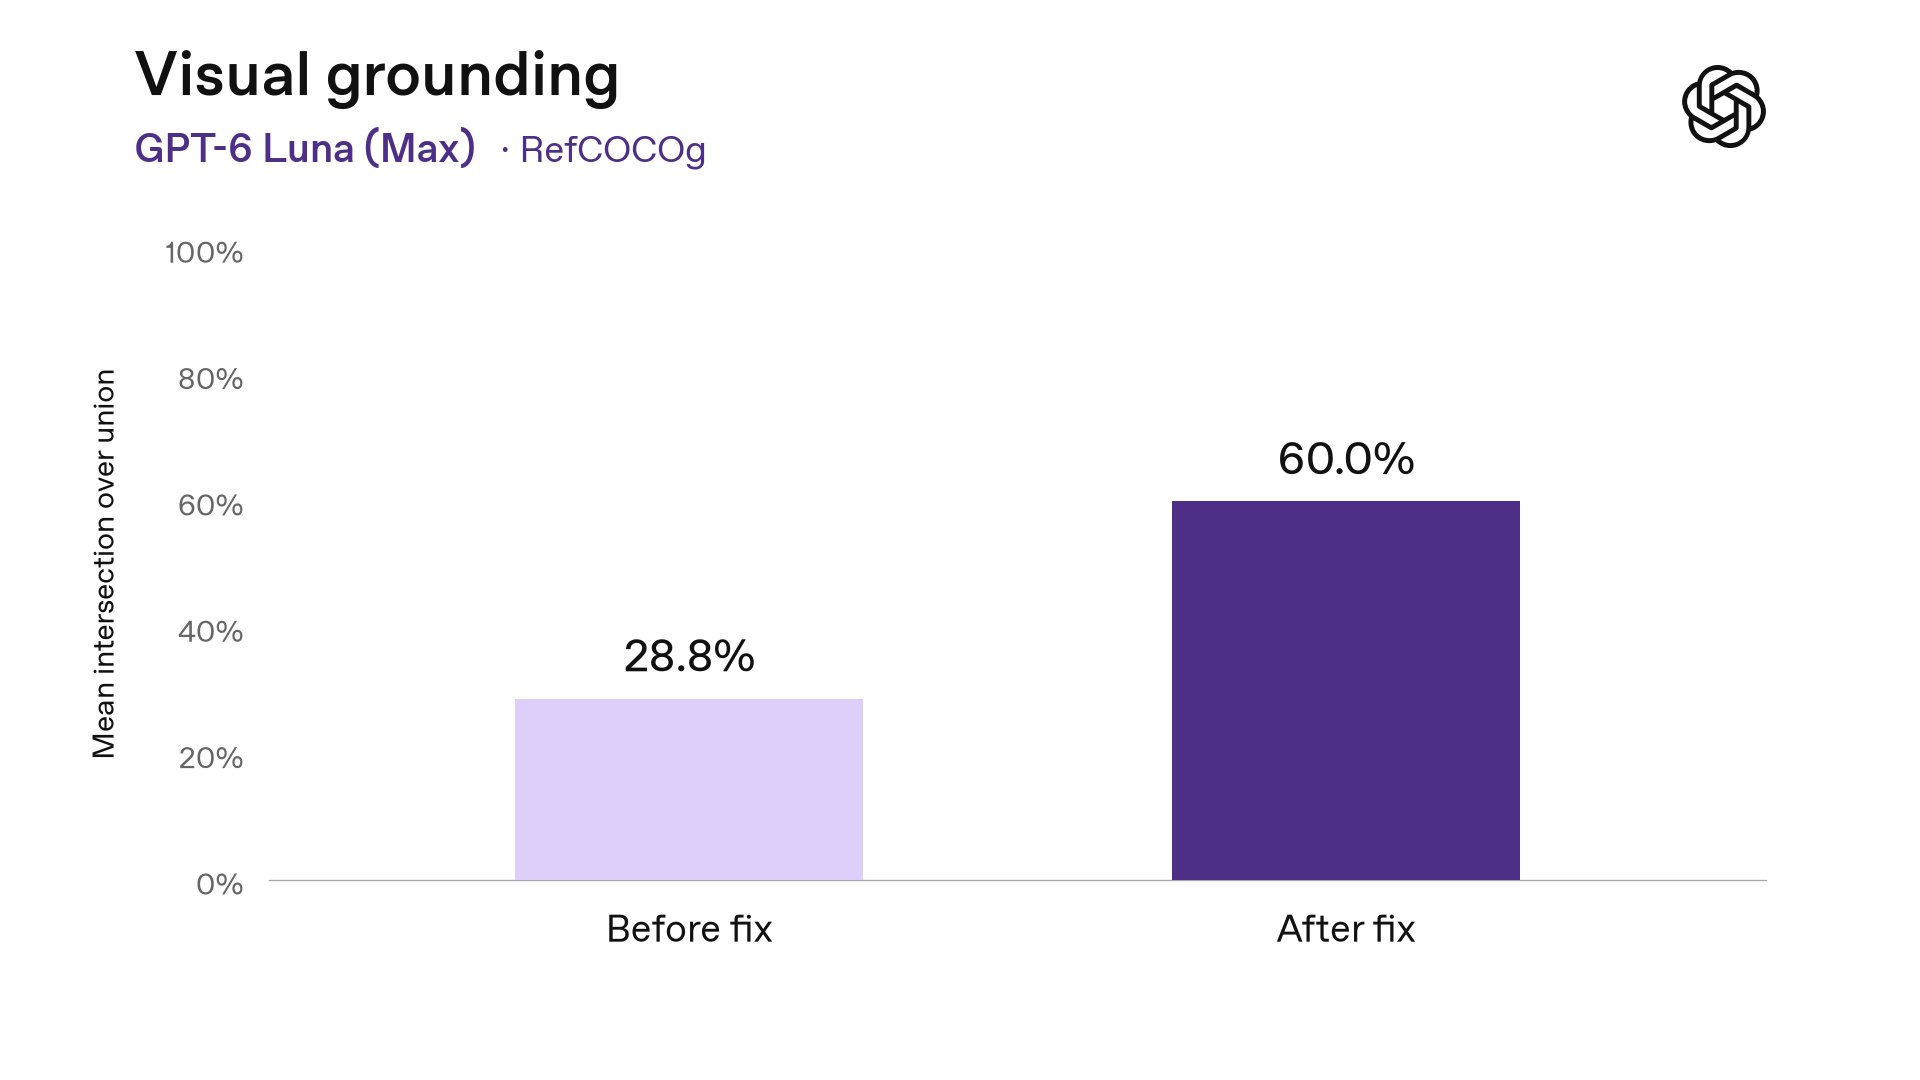
RefCOCOg用于评估视觉定位能力:系统根据自然语言描述,在图片中找出对应对象或区域。mIoU,即平均交并比,用于衡量模型预测区域与真实区域的重合程度,数值越高,表示定位越准确。
从28.8%提升至60.0%说明,这不是一个几乎无法感知的小修复。此前的编码问题可能显著削弱了模型理解图片中“哪个对象在哪里”的能力。
不过,这张图只展示GPT-6 Luna在一个基准上的结果。OpenAI没有在推文和更新日志中公布Sol的具体修复前后分数,也没有给出所有视觉任务的平均提升幅度。因此,不能把“翻倍”扩展为两个模型在所有图像任务上都翻倍。
哪些使用场景可能受到影响
GPT-6 Sol和Luna于9月22日上线,支持文本和图像输入,并用于API、Codex以及计算机操作。图像编码异常可能影响以下任务:
截图理解
模型读取网页、App或桌面截图时,可能识别错按钮、图标、菜单和文本所在位置。
计算机操作
计算机Agent通常需要反复截图,再决定点击、输入或滚动的位置。视觉定位误差会让后续动作全部偏离,形成“看错一次、整条任务失败”。
前端开发与视觉测试
Codex根据界面截图检查页面布局、对比设计稿或修复样式问题时,可能误判元素位置与状态。
图表和文档分析
表格截图、流程图、仪表盘和扫描文档中的结构识别可能下降,进而影响数字提取和结论。
图片问答与对象定位
让模型回答“左侧第二个按钮是什么”“哪个商品符合描述”等问题时,答案可能不稳定。
受影响程度取决于任务是否依赖图像输入。文本编程、纯文本总结和不读取截图的工具调用,不应因为这次视觉Bug被直接判定为不可靠。
为什么输入编码Bug会造成这么大差距
多模态模型并不是直接读取原始图片文件。图像通常会经过解码、缩放、分块、归一化和视觉Token转换,再交给模型推理。
任何环节出现错误,都可能导致:
- 图片尺寸或比例处理异常
- 局部区域分辨率不足
- 坐标映射发生偏移
- 图像Token缺失或顺序错误
- 高细节模式没有正确生效
- 图片与文字提示没有正确对应
OpenAI目前只说明是图像编码问题,没有公开具体根因、受影响请求比例、开始时间或技术修复细节。上述情况是常见风险,并非官方对本次Bug的具体归因。
这一事件说明,多模态系统的最终表现不仅由模型权重决定,输入预处理、服务配置和执行框架同样关键。模型本身再强,如果“眼睛”接收到的图像有问题,推理能力也无法正常发挥。
为什么计算机操作对视觉缺陷特别敏感
计算机操作通常形成一个循环:
- 获取当前屏幕截图
- 识别界面元素和状态
- 选择下一步动作
- 点击、输入或滚动
- 再次截图并检查结果
如果第一步图像编码失真,模型可能点击错误位置;界面随后改变,下一轮判断建立在错误状态上,最终导致任务失败甚至执行高风险操作。
因此,视觉Agent不能只依靠模型一次判断。生产系统应增加:
- 点击前后截图对比
- 关键按钮文字或DOM的二次验证
- 付款、发送、删除等动作的人工确认
- 坐标越界和界面变化检测
- 失败后的回退与重新定位
本次Bug虽然已修复,但这些保护仍然必要,因为网页变化、弹窗遮挡和分辨率差异同样会引发定位错误。
开发者现在应该做什么
OpenAI在更新日志中明确建议:涉及图像输入的用户,应重新运行评估,并重试此前受影响的工作流。
重跑视觉评估集
不要只测试官方RefCOCOg。应使用自己的截图、扫描件、图表和业务图片,比较修复前后的成功率。
复查最近失败任务
重点检查9月22日模型上线后出现的视觉异常,例如按钮定位错误、截图内容漏读、表格识别下降和界面测试失败。此前被归因于提示词或模型能力的问题,可能实际上来自编码Bug。
不要沿用旧评测结论
如果团队在修复前比较GPT-6 Sol、Luna与其他模型的视觉能力,那些结果可能已经失效。模型选型、路由和成本配置应基于修复后的数据重新决定。
保留固定回归样本
建立一套包含小字、密集界面、不同分辨率、遮挡、暗色模式和多对象定位的视觉回归集。供应商后台更新后,自动检查性能是否变化。
记录模型与请求配置
保存模型名、推理强度、图片尺寸、细节设置、请求时间和输出结果。否则发生静默服务端更新时,很难解释质量为何变化。
这次修复暴露了“静默更新”风险
GPT-6 Sol和Luna上线仅数天,OpenAI便修复了会显著影响视觉能力的服务端问题。开发者无需更换模型ID即可获得改善,这对用户很方便,却也带来可复现性问题。
同一个模型名、同一段提示词和同一张图片,在不同日期可能得到明显不同结果。原因未必是随机性,也可能是供应商修复了预处理或推理服务。
对于严肃生产应用,团队不能只在上线前评估一次,而应持续监控:
- 固定样本成功率
- 图像定位准确率
- 计算机操作完成率
- 单任务重试次数
- 人工接管比例
- 不同日期和区域的结果差异
模型即服务意味着能力不仅来自静态权重,还来自不断变化的托管栈。
这是否会影响发布时的官方基准
OpenAI没有说明发布GPT-6 Sol和Luna时展示的视觉或计算机操作基准,是否使用了存在缺陷的编码链路,也没有更新完整基准表。
因此,目前不能确定:
- 发布基准是否低估了模型真实能力
- 缺陷是否只影响部分线上请求
- API、Codex和内部评估是否使用完全相同的编码路径
- Sol与Luna各自受到多大影响
唯一可以确认的是,官方已承认线上图像理解受到损害,并建议开发者重跑评估。后续如OpenAI公布更完整的根因分析和基准更新,才能进一步判断影响范围。
总结
OpenAI已修复GPT-6 Sol和Luna的图像编码Bug。该问题曾降低API和Codex中的图像理解能力,并影响计算机操作。官方图表显示,GPT-6 Luna在RefCOCOg视觉定位测试中的mIoU从28.8%恢复至60.0%。
这不是一次新模型发布,而是托管输入链路修复。它说明多模态模型的性能不仅取决于训练,还取决于图片如何被编码和送入模型。
使用Sol或Luna处理截图、文档、图表、前端视觉测试和计算机操作的开发者,应立即重跑评估,复查近期失败案例,并更新模型选型结论。对于生产级Agent,持续回归测试和关键动作确认比相信一次发布跑分更重要。
创建: 2026-09-28
关联文章推荐
- OpenAI发布GPT-6 Sol与Luna:API价格减半,模型竞争转向性价比
- Claude Opus 5.5正式发布:性能、价格与实际应用全解析
- Claude Opus 5.5发布:性能逼近Fable 5.1,典型任务成本降低40%
- 腾讯QClaw宣布停运:12月24日关闭,用户可退款并迁移至WorkBuddy
- 26日凌晨 OpenAI Codex 崩了!Codex 服务全面中断,官方已恢复
- OpenAI神秘助理“o”要来了?DevDay前夕,可信消息只有这些
- OpenAI修复GPT-6 Sol与Luna图像编码缺陷:视觉定位成绩从28.8%升至60%
- OpenAI将重开200美元Pro订阅:名义用量价值减半,取消5小时窗口并增加免计费权益
- OpenAI发布Dot常驻智能体:GPT-6 Astra驱动,连接4000多款应用并全天候工作
- OpenAI推出类Jev的Decisions API:GPT-6 Luna实时分类与路由,官方演示快约10倍
- OpenAI确认老Pro 200额度腰斩:10月30日起降至Plus 10倍,补偿2500美元额度
- Cloudflare 开源 Clef 与 Clef-flash:为 AI 智能体做选择的决策模型
- OpenAI Bel 与 Fable 5.5 传闻升温:下一轮 AI 模型竞争看什么?
- Android CLI接入云端真机:AI Agent也能部署应用、抓日志和截图
- Tibo推文下1354条评论告诉我们:OpenAI的产品价值合同被破坏了
- Google开放SynthID水印检测:能查AI图片视频,但查不到不等于真实

 消息提醒
登录后才能发布评论哦
立即登录/注册